LM Studio и Gemma 4 позволяют запустить модель искусственного интеллекта прямо на офисном компьютере. Контракты, сметы, балансы и внутренние отчёты обрабатываются локально — ни одного байта не уходит на серверы OpenAI, Google или Anthropic.
Два условия сделали эту связку пригодной для работы совсем недавно. Google выпустила Gemma 4 2 апреля 2026 года под лицензией Apache 2.0, допускающей коммерческое использование без отдельных соглашений. LM Studio стала бесплатной для бизнеса с 8 июля 2025 года — без анкет и запроса лицензий. На этом блоге мы уже разбирали запуск через командную строку с Ollama, Gemma 4 и агентом Hermes. Здесь цель иная: приложение с графическим интерфейсом, которым в офисе может пользоваться кто угодно, работая со своими файлами без единой команды в терминале.
По опыту, связка неплохо работает даже на ноутбуке без дискретной видеокарты — главное, правильно подобрать размер модели под доступную память. Выбору размера посвящена таблица ниже.
Почему корпоративные документы не должны попадать в облако
Когда контракт вставляют в ChatGPT или баланс загружают в онлайн-чат-бот, файл уходит на серверы стороннего поставщика, часто за пределы России. Согласно Федеральному закону № 152-ФЗ «О персональных данных», такой провайдер становится лицом, осуществляющим обработку персональных данных по поручению компании. С личными аккаунтами сотрудников ситуация ещё хуже — в этом случае зарубежный поставщик сам решает, как использовать вашу информацию. Для легальной работы необходим официальный письменный договор, а передача данных на зарубежные серверы накладывает жесткие обязательства по трансграничной передаче данных. В РФ за невыполнение требований по локализации баз данных на территории страны предусмотрены оборотные штрафы.
Судебная и регуляторная практика по всему миру показывает, что разработчики нейросетей регулярно нарушают конфиденциальность. Крупные штрафы и расследования в отношении OpenAI наглядно доказывают: зарубежные ИИ-сервисы массово используют загруженные пользовательские данные для обучения своих моделей без всякого законного основания и согласия авторов.
При этом есть документы, которые закон «О персональных данных» вообще не охватывает, так как они не содержат личной информации сотрудников или клиентов. Однако они представляют огромную ценность для бизнеса: коммерческие предложения, технические проекты, исходный код программ, финансовая отчетность и протоколы заседаний совета директоров. В данном случае ограничения диктуются режимом коммерческой тайны, соглашениями о конфиденциальности (NDA) и здравым смыслом.
С локальным инференсом (запуском ИИ-модели на собственном оборудовании компании вместо удаленного облака) эта проблема решается в корне. Нейросеть превращается в обычный файл на вашем сервере, все вычисления выполняются на видеокартах или процессорах внутри корпоративного периметра, а секретный документ никогда не покидает компанию.
Требования российского законодательства по защите информации при этом никуда не исчезают. Компания обязана защищать локальный сервер с ИИ так же строго, как и любую другую базу данных или архив: настраивать шифрование дисков, разграничивать права доступа по корпоративным паролям и регулярно делать резервные копии. Однако из цепочки полностью исчезает самое уязвимое звено — сторонний зарубежный провайдер, который мог видеть и использовать ваши коммерческие секреты.
Что такое LM Studio и что она делает
LM Studio — бесплатное настольное приложение для macOS, Windows и Linux. Оно скачивает открытые языковые модели (Gemma, Qwen, Llama) и запускает их локально с интерфейсом, похожим на ChatGPT. Есть сервер, совместимый с API OpenAI, для подключения к другим программам.
Под капотом работают два движка. Первый — llama.cpp, открытый проект на C/C++, на котором держится значительная часть локального ИИ, включая Ollama. Второй — MLX, фреймворк Apple для чипов M. Модели поставляются в двух форматах: GGUF (сжатый формат llama.cpp) и MLX. На Mac нужен процессор Apple Silicon с macOS 14 или новее. Самая свежая версия на момент написания — 0.4.25, вышедшая 19 сентября 2026 года.
Специалист по безопасности сразу заметит деталь про код. Настольное приложение от Element Labs имеет закрытый исходный код, но на GitHub открыты командная строка lms, SDK для Python и TypeScript, а также движок MLX. По сравнению с Ollama, созданной для терминала, LM Studio выигрывает в простоте использования: поиск моделей и чат с документами находятся в одном окне. Именно поэтому приложение подходит коллегам, которые никогда не набирали ни одной команды. Те, кто предпочитает командную строку, найдут всё в нашем руководстве по Ollama для начала работы с локальными LLM.
Какую версию Gemma 4 выбрать в зависимости от объёма ОЗУ
Gemma 4 существует в пяти размерах. Буква «E» в E2B и E4B означает эффективные параметры — часть весов служит только представлениям слов и не нагружает вычисления. 26B A4B — модель MoE (Mixture of Experts, архитектура, где для каждого слова активируется только часть сети). Из 25,2 миллиарда параметров одновременно работают 3,8, поэтому модель быстра как небольшая, но требует памяти как большая. Все версии читают изображения, а три самые младшие — ещё и аудио. Согласно официальной карточке на Hugging Face, языковая поддержка охватывает более 140 языков, включая русский.
| Модель | Параметры | В LM Studio | Подходящий компьютер | Контекст |
|---|---|---|---|---|
| Gemma 4 E2B | 2,3 млрд эффективных | 4,2 ГБ | Ноутбук с 8 ГБ ОЗУ | 128K |
| Gemma 4 E4B | 4,5 млрд эффективных | 5,9 ГБ | Ноутбук с 16 ГБ ОЗУ (от 8 ГБ) | 128K |
| Gemma 4 12B | 11,95 млрд | 7,4 ГБ | Mac или ПК с 16 ГБ унифицированной / ОЗУ | 256K |
| Gemma 4 26B A4B | 25,2 млрд (3,8 активных) | 15,6 ГБ | Станция от 24 ГБ ОЗУ / GPU от 24 ГБ VRAM | 256K |
| Gemma 4 31B | 30,7 млрд | 19,0 ГБ | Профессиональная рабочая станция от 32 ГБ | 256K |
Размеры загрузки указаны LM Studio на странице модели. Столбец с подходящим компьютером — практическая рекомендация с учётом места для операционной системы и анализируемого документа, который тоже занимает память. Не знаете, сколько видео- или унифицированной памяти у вас есть — начните с бесплатных инструментов для проверки, потянет ли ПК локальный ИИ.
Для офисной работы самый разумный выбор почти всегда 12B. Google представляет её как модель с производительностью, близкой к 26B, но с менее чем половиной объёма памяти. Цифры из технической карточки подтверждают: на тесте общих знаний MMLU Pro 12B набирает 77,2%, 26B — 82,6%, 31B — 85,2%, а E4B останавливается на 69,4%. Разрыв между E4B и 12B заметен в ответах, а между 12B и 31B гораздо меньше — по крайней мере на задачах суммирования и извлечения данных. В посте презентации от 3 июня 2026 года Google указывает 16 ГБ памяти как требование — конфигурацию многих современных корпоративных ноутбуков. О том, как 12B работает на Mac, мы уже рассказывали в статье о Gemma 4 12B и локальном агентном ИИ с Google AI Edge.
С июня 2026 года LM Studio предлагает варианты QAT (Quantization-Aware Training — обучение, учитывающее сжатие весов до 4 бит). Файл весит столько же, но сжатие теряет меньше качества. Если в списке есть оба варианта, стоит скачать QAT.
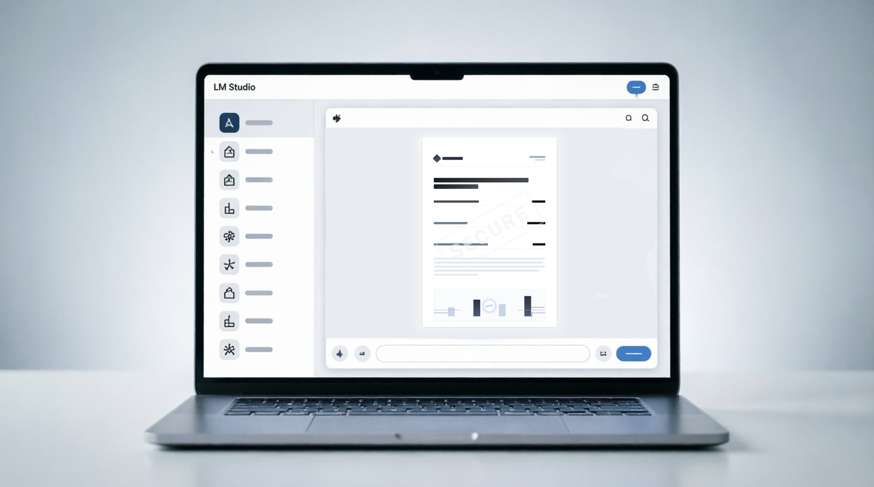
Как установить Gemma 4 в LM Studio: пошагово
Установка требует десятка кликов и загрузки в несколько гигабайт. Вот последовательность действий:
- Скачайте LM Studio с официального сайта и установите как обычную программу
- Откройте раздел поиска моделей (иконка с лупой) и введите «gemma 4»
- Выберите google/gemma-4-12b или вариант QAT, если доступен. На Mac лучше формат MLX, на остальных системах — GGUF
- Загрузите модель и в настройках загрузки увеличьте длину контекста — значение по умолчанию осторожное, не хватит для контракта на тридцать страниц
- Откройте новый чат, перетащите документ в окно и задайте вопрос
Если модель не загружается, проблема обычно в неактуальном движке выполнения. LM Studio сообщила об этом именно для Gemma 4, указав решение — команду lms runtime update --all. Кто управляет несколькими рабочими местами, может сделать всё через терминал с помощью CLI lms, устанавливаемой вместе с приложением.
# обновляет движки выполнения (llama.cpp и MLX)
lms runtime update --all

# скачивает Gemma 4 12B
lms get google/gemma-4-12b

# загружает её с широким контекстом для длинных документов
lms load google/gemma-4-12b --context-length 32768
Чат с контрактами и PDF: как работает RAG в LM Studio
Функция, которая по-настоящему интересна компании, — «чат с документами». Согласно документации LM Studio, она принимает файлы .docx, .pdf и .txt и работает двумя способами. Если документ достаточно короткий, чтобы поместиться в окно контекста модели (объём текста, который модель учитывает за раз), приложение вставляет его целиком в разговор. Если слишком длинный — в дело вступает RAG (Retrieval-Augmented Generation, техника, которая ищет в документе релевантные вопросу фрагменты и передаёт модели только их).
Разница сказывается на результатах. С целым документом модель видит всё и может сопоставить статью 3 с приложением B. С RAG она видит только найденные поиском фрагменты. Если поиск ошибся с фрагментом, ответ ошибётся тоже. При 256K токенов контекста у 12B контракт на тридцать-сорок страниц помещается целиком, если длина контекста была увеличена при загрузке и памяти хватает — каждый лишний токен занимает ОЗУ. Документация даёт простой совет: писать в вопросе термины, которые ожидаются в тексте. «Какие штрафы предусматривает контракт за задержку поставки?» работает лучше, чем «есть ли проблемы?».
Запросы, которые хорошо работают с Gemma 4 12B:
- «Перечисли обязательства поставщика и укажи для каждого статью контракта»
- «Изложи этот протокол в восьми пунктах: принятые решения и ответственных за их выполнение»
- «Сравни два приложенных предложения по цене и срокам поставки»
- «Найди в техническом задании пункты об интеллектуальной собственности и приведи их дословно»
Два случая требуют дополнительного шага. Таблицы Excel и презентации не поддерживаются, поэтому их нужно экспортировать в текст или PDF перед загрузкой. Сканированные PDF — изображения без выделяемого текста, поиску нечего читать. Их можно пропустить через программу OCR (оптическое распознавание символов) или, поскольку Gemma 4 читает изображения, приложить страницу как фото и попросить модель её расшифровать.
Остаётся правило, справедливое для любой модели, локальной или облачной. Gemma 4 может выдумать деталь с той же уверенностью, с какой сообщает достоверный факт, поэтому по ключевым пунктам стоит просить дословную цитату и сверять с оригиналом документа. Кто хочет пойти дальше чата — с архивами из сотен файлов и несколькими пользователями — альтернатива с открытым кодом это AnythingLLM, подключающийся к LM Studio как к движку.
Что остаётся на компьютере, а что нет
Политика конфиденциальности LM Studio, обновлённая в июне 2026 года, однозначна насчёт контента. При моделях, скачанных и выполняемых локально, компания пишет: «none of your messages, chat histories, and documents are ever transmitted» — сообщения, история и документы остаются на устройстве. Та же страница заявляет, что приложение не собирает телеметрию и не отслеживает отдельных пользователей.
Исходящие соединения существуют, но всего два, и касаются другого. При поиске или скачивании модели приложение отправляет запрос анонимно. При проверке обновлений передаются версия приложения, операционная система и IP-адрес через сеть распространения поставщика. Ни то, ни другое не содержит текста документов.
Но есть предостережение. LM Studio предлагает дополнительные облачные сервисы: удалённые модели, веб-поиск и агента Bionic, который может опираться на модели на серверах (GLM 5.2, Kimi K3). В этом случае запросы выходят за пределы компьютера с договорной гарантией Zero Data Retention (поставщик обязуется не сохранять данные). Для конфиденциальных документов правило простое: использовать только локально скачанные модели и держать облачные функции выключенными. Проверка занимает тридцать секунд: модель скачивается, Wi-Fi отключается, работа продолжается. Если чат отвечает — документ никуда не уходит.
Как подключить к Gemma 4 весь офис через локальный сервер
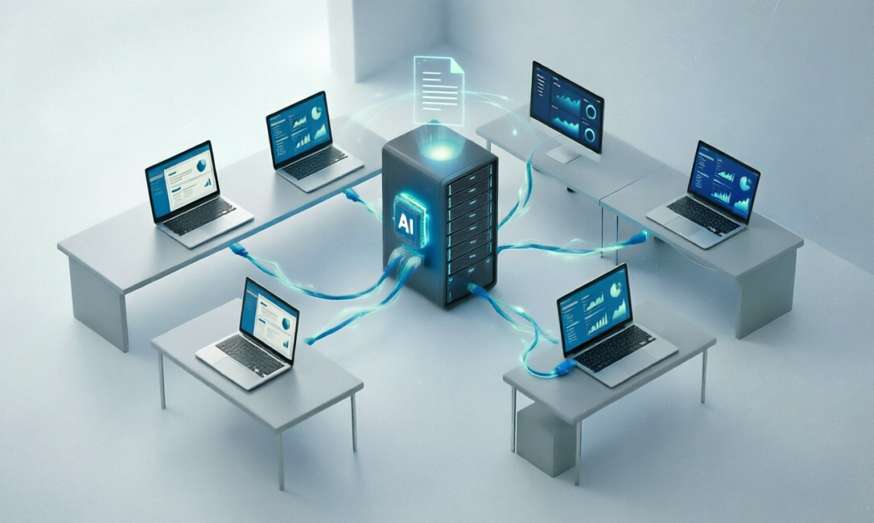
Установка на каждое рабочее место подходит для специалиста или небольшого офиса. В компании с десятью-двадцатью сотрудниками разумнее разместить модель на мощной машине и обращаться к ней с остальных компьютеров. LM Studio предоставляет сервер, совместимый с API OpenAI, по адресу http://localhost:1234/v1, поэтому любая программа для ChatGPT подключается к Gemma 4, меняя только адрес.
# запускает локальный сервер
lms server start

# отправляет запрос к Gemma 4 в формате API OpenAI
curl http://localhost:1234/v1/chat/completions
  -H "Content-Type: application/json"
  -d '{
    "model": "google/gemma-4-12b",
    "messages": [
      {"role": "user", "content": "Изложи в пяти пунктах это условие о расторжении договора"}
    ]
  }'
Чтобы открыть сервер другим компьютерам, есть опция «Serve on Local Network». Документация предупреждает: любой адрес, отличный от 127.0.0.1, открывает сервис за пределы локальной машины, и рекомендует включить аутентификацию. С версии 0.4.21 от 12 августа 2026 года сервер поддерживает API-ключи для внутренних корпоративных сетей. Каждый ключ получает отдельные разрешения на чат, на внешние инструменты через MCP (Model Context Protocol — стандарт, связывающий модели с программами и хранилищами), и на каждый инструмент по отдельности. Их нужно включать всегда. Случай Bleeding Llama с 300 000 серверов Ollama, открытых в интернете, показывает, что происходит, когда сервер локальных моделей остаётся без защиты.
Для сервера без экрана (например, Linux в серверной комнате) с версии 0.4.0 от 28 января 2026 года существует llmster — ядро LM Studio, работающее как служба без графического интерфейса. Та же версия ввела continuous batching (параллельную обработку нескольких запросов вместо очереди) с четырьмя одновременными запросами по умолчанию. Для офиса среднего размера этого более чем достаточно. Кто выбирает оборудование, найдёт ориентиры в руководстве по мини-ПК для локального ИИ.
Ограничения, которые нужно учитывать
Gemma 4 12B играет не в той лиге, что Claude или GPT. В длинных рассуждениях и анализе, требующем множества шагов, ведущие облачные модели остаются на ступень выше. Разрыв сильно сокращается на задачах, которые действительно занимают офисный день: суммирование, извлечение данных, перевод, переписывание письма в более формальном тоне, сравнение двух версий документа.
Скорость зависит от оборудования больше, чем от модели. На Mac с современным чипом M или на ПК с видеокартой на 16 ГБ ответы идут плавно. На офисном ноутбуке пятилетней давности с 8 ГБ ОЗУ 12B даже не помещается в память — стоит перейти на E4B, смирившись с менее точными ответами. Руководство по лучшим локальным LLM 2026 года помогает понять, какие альтернативы Gemma работают на конкретной машине, включая Qwen.
Остаётся закрытый код приложения. Никто не может построчно проверить, что LM Studio делает именно то, что обещает политика конфиденциальности. Можно, однако, наблюдать за сетевым трафиком с помощью исходящего файрвола (на Mac — Little Snitch) или использовать приложение на машине, отключённой от интернета. Кому нужна полностью проверяемая цепочка, придётся перейти на инструменты с открытым кодом вроде Ollama или llama.cpp, пожертвовав частью удобства.
Часто задаваемые вопросы (FAQ)
1. LM Studio бесплатен для компании?
Да, LM Studio бесплатен для корпоративного использования с 8 июля 2025 года. Раньше требовалась отдельная коммерческая лицензия — требование, которое компания отменила объявлением в своём блоге. Остаётся платный план Enterprise для тех, кто хочет доступ с корпоративным аккаунтом (Single Sign-On), централизованный контроль над моделями и инструментами для сотрудников, и приватный обмен в команде.
2. Gemma 4 можно использовать в коммерческих целях?
Да, Gemma 4 распространяется по лицензии Apache 2.0, разрешающей коммерческое использование, изменение и распространение. Это чёткая перемена по сравнению с предыдущими версиями с собственной лицензией Google и ограничениями. Google объяснила выбор в блоге, посвящённом открытому коду.
3. Нужна ли дискретная видеокарта для локального использования Gemma 4?
Нет, Gemma 4 работает без дискретной видеокарты, если памяти достаточно. На Mac с чипом Apple унифицированная память служит одновременно ОЗУ и видеопамятью — Mac с 16 ГБ хорошо тянет 12B. На ПК с Windows видеокарта заметно ускоряет обработку, но LM Studio может загрузить модель в системную ОЗУ с более долгим временем отклика.
4. LM Studio работает без интернета?
Да, после скачивания модели LM Studio работает полностью офлайн. Подключение нужно только для поиска и скачивания моделей и проверки обновлений. Это же самый простой способ показать клиенту или ответственному за защиту данных, что документы не покидают компанию.
5. Gemma 4 подходит для документов на русском языке?
Да, Gemma 4 поддерживает более 140 языков, русский в их числе. Суммирование, извлечение пунктов и переписывание текстов работают на русском без необходимости перевода документа. На очень технических терминах (юридических или отраслевых) более крупные модели ошибаются реже, поэтому для контрактов и технических заданий стоит выбирать самый большой размер, который позволяет память.
6. Можно ли использовать Gemma 4 для рукописных текстов или фото документов?
Да, Gemma 4 читает изображения, поэтому может расшифровывать и анализировать фото документов. В LM Studio достаточно прикрепить изображение к чату как файл. Качество зависит от чёткости фото и почерка. На печатном счёте, хорошо сфотографированном, расшифровка обычно надёжна. На записи, сделанной второпях, всегда стоит перепроверить.
Заключение
Для профессиональной практики или небольшой компании LM Studio с Gemma 4 12B на компьютере с 16 ГБ — сегодня самый экономичный способ подключить ИИ к документам без юридических вопросов с внешним поставщиком. Стоимость лицензий — ноль. Стоимость оборудования — часто тоже ноль, потому что многие современные корпоративные ноутбуки уже обладают нужной памятью. Остальное — дело привычки: понять, какой размер модели тянет ваша машина, и научиться формулировать точные вопросы.
На практике:
Установите LM Studio, скачайте Gemma 4 12B (7,4 ГБ, лучше вариант QAT), увеличьте длину контекста и держите облачные функции выключенными. Контракты и PDF остаются на вашем диске, и это можно проверить, отключив Wi-Fi, пока модель отвечает.