Запуск большой языковой модели дома перестал быть развлечением для энтузиастов с фермой видеокарт. Одна команда в терминале — и на localhost отвечает модель, а данные не уходят ни на один внешний сервер. Но вопрос «какая модель лучшая» по-прежнему поставлен неверно. Правильный звучит так: какая модель лучшая для моего объёма памяти и моей задачи. Ответ пересматривается каждые два-три месяца, потому что открытые веса обновляются быстрее, чем железо.
Память — единственный жёсткий ограничитель
Всё упирается в VRAM (на Mac — в общий объём унифицированной памяти). Модель занимает столько места, сколько у неё параметров и насколько сильно она сжата. Сжатие называется квантованием: вместо 16 бит на вес используется 8 или 4. Формат Q4 сокращает объём примерно на 75% и на бытовых задачах почти не влияет на качество ответов — именно он сделал локальный ИИ реальностью. Q8 сохраняет качество практически исходным, но требует вдвое больше памяти.
Важная деталь, о которой забывают: веса — не всё. Отдельно расходуется память под KV-кэш, и он растёт линейно с длиной контекста. Модель, которая «влезла» на 8 ГБ с контекстом 4k, может упасть на 32k. Поэтому запас в 2–3 ГБ сверх размера файла — не роскошь, а необходимость.
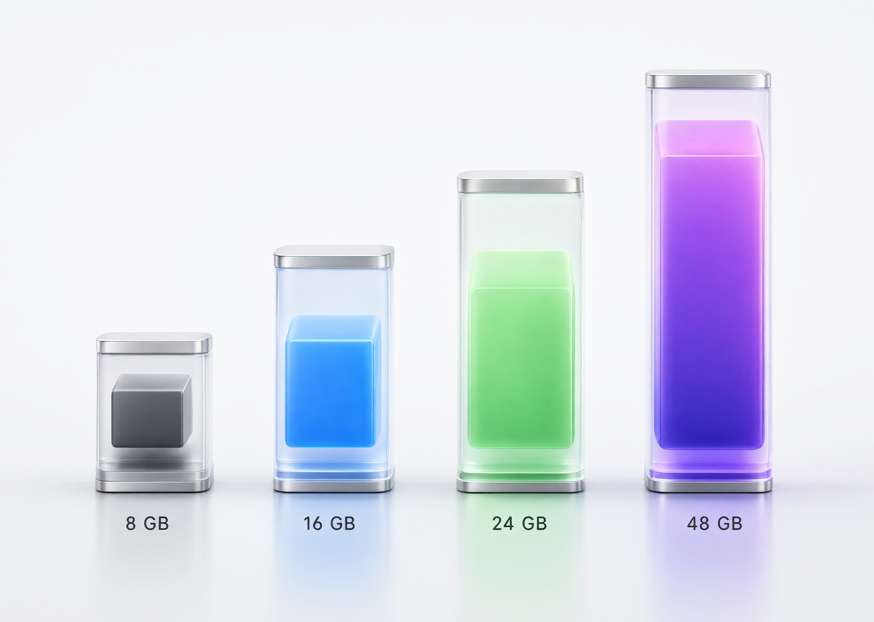
| Память | Размер модели (Q4) | Реальные возможности |
|---|---|---|
|
8 ГБ или только CPU
|
1B–8B | Чат, пересказы, черновики, перевод. Код — слабо |
|
16 ГБ
|
до 14B | Полноценный ассистент, многоязычность, фрагменты кода |
|
24 ГБ
|
до 30B | Кодовые агенты, рассуждения, ежедневная работа |
|
32–48 ГБ и выше
|
32B–70B | Качество, близкое к облачному, глубокий анализ |
Отдельный случай — архитектуры со смесью экспертов (MoE). На каждом токене активна лишь часть сети, поэтому модель на 30B с 3B активных параметров считает со скоростью маленькой модели, но память требует как большая. Скорость и размер здесь развязаны, и это самый выгодный класс моделей для 24 ГБ.
По скорости ориентир простой: 10–15 токенов в секунду — это темп комфортного чтения. Модель на 8B на одном CPU с нормальной RAM выдаёт примерно столько. На RTX 4080 те же веса идут 80–120 токенов в секунду, на Mac с чипом M — 40–60. Разница ощущается не в чате, а в агентных сценариях, где модель делает десятки вызовов подряд.
Модели, которые стоит держать установленными
Универсального победителя нет. У каждого семейства свой характер.
Qwen3 — выбор по умолчанию. Линейка от 1,7B до 235B закрывает любое железо, лицензия Apache 2.0 не создаёт проблем даже в коммерции. Лучший баланс качества, языков и работы с инструментами. Для 16 ГБ — 14B, для 24 ГБ — 30B в варианте MoE. Отдельная ветка Coder — один из сильнейших локальных вариантов для программирования.
Llama — самая простая точка входа. Документация и сообщество больше, чем у кого-либо, любой сторонний инструмент поддерживает её первым. Llama 4 Scout выделяется длинным контекстом, что удобно при работе с архивами документов через поиск по своим файлам. Лицензия Community строже Apache, но для личного использования разницы нет.
DeepSeek — когда нужно думать. Эталон открытых весов в задачах с логическими шагами: математика, разбор сложных багов, многоэтапный анализ. Рассуждающие версии «проговаривают» ход решения перед ответом; дистиллированные варианты переносят часть этой способности на скромные карты, хотя полноценно раскрываются только на 24 ГБ и выше.
Gemma 4 — если у вас Mac. Семейство уже давно отлично приспособлено к Apple Silicon: на рантайме MLX версия 26B A4B обгоняет сопоставимые Llama и Qwen. Варианты 4B, 12B и 26B понимают изображения, а не только текст.
Mistral и Devstral — про код. Mistral Small силён в вызовах функций, то есть в аккуратном обращении к внешним инструментам. Devstral на 24B под Apache 2.0 создавался под агентов, работающих с целым проектом, а не с отдельным фрагментом; на 24 ГБ помещается свободно.
Phi-4-mini и gpt-oss — крайние случаи. Первый (3,8B, MIT) живёт на 8 ГБ и даже на одном процессоре, неожиданно хорош в STEM-задачах. Вторые — открытые веса OpenAI на 20B и 120B под Apache 2.0 — вариант для тех, кому нужны серьёзные рассуждения при полной изоляции данных.
Инструмент важнее, чем кажется
Модель — двигатель, оболочка — кузов. Почти под всеми ней лежит llama.cpp, движок на C++, и выбор оболочки определяет, потратите вы пять минут или весь день.
| Инструмент | Кому | Сильная сторона |
|---|---|---|
|
›_ Ollama |
Тем, кто живёт в терминале | Одна команда — и локальный API, совместимый с OpenAI |
|
LM LM Studio |
Тем, кто хочет окно и ползунки | Сравнение моделей рядом, подбор параметров без CLI |
|
C++ llama.cpp |
Тем, кому нужен контроль | Никаких посредников, каждый флаг доступен |
|
J Jan |
Тем, кто не хочет настраивать | Работает сразу после установки, полностью офлайн |
|
v vLLM |
Для сервера и продакшна | Параллельные запросы, высокая пропускная способность |
Для большинства сценариев достаточно Ollama: установка, ollama run qwen3, и через несколько минут к localhost:11434 можно направить любое приложение, умеющее говорить с OpenAI-совместимым API. Ограничение одно, но существенное: запросы обрабатываются последовательно, и при нескольких одновременных пользователях задержка растёт лавинообразно. Для экспериментов и сравнения моделей удобнее LM Studio, для нагрузки — vLLM.

Что ставить под конкретное железо
- Mac, 16 ГБ и больше. Gemma 4 первой, Qwen3 14B второй. Оболочка — LM Studio или Ollama, рантайм MLX даёт заметный прирост.
- 16 ГБ VRAM. Qwen3 14B на общее, Phi-4 на математику, Gemma 4 12B если нужны изображения.
- 24 ГБ (RTX 3090/4090). Qwen3 30B MoE как рабочая лошадка, Devstral 24B под агентов, DeepSeek под рассуждения. Здесь локальный ИИ впервые действительно закрывает большую часть облачных задач.
- 8 ГБ или только CPU. Phi-4-mini либо Gemma 4 4B. Чата, пересказов и черновиков хватит, чудес в коде ждать не стоит. Контекст держите коротким, иначе упрётесь в KV-кэш.
Экономика: локально против подписки
Подписка на фронтир стоит от 20 до 200 долларов в месяц и всегда даёт максимум доступного качества без хлопот. Локальный ИИ требует вложений один раз — карта или Mac, — после чего стоимость токена равна нулю навсегда, плюс электричество. Расчёт сходится при интенсивной работе, при требованиях к приватности или при необходимости работать офлайн.
На повседневных задачах — письмо, пересказ, обычный код, разбор документов — разница между хорошей локальной моделью на 27–30B и облаком почти не чувствуется. На предельных сценариях (очень длинные цепочки рассуждений, огромные кодовые базы) облако впереди. Практичная стратегия — не выбирать, а совмещать: локальная модель на основной поток и приватные данные, подписка на редкие тяжёлые случаи.
Когда речь о сервере на весь офис
Ноутбук обслуживает одного человека, сервер — десятки одновременно, и это другая инженерная задача. Ollama здесь не годится: очередь запросов убивает время ответа. Нужен vLLM с управлением памятью, удерживающим множество параллельных диалогов, и железо класса A100/H100 либо кластер из нескольких RTX 4090. Модель подбирается под число одновременных пользователей, а не под одну задачу: квантованный Qwen3 30B выдерживает команду на одной машине, дальше требуется масштабирование.
Мотив у компаний почти всегда один — данные. Модель на собственных серверах не отправляет наружу ни байта, что резко упрощает соблюдение регуляторных требований и работу с конфиденциальной информацией клиентов. Плата за токены исчезает, остаются капитальные затраты и люди, которые всё это поддерживают. При постоянной высокой нагрузке выгодно, при редкой — по-прежнему дешевле облачный API с оплатой по факту.
Коротко
- Сначала смотрите на память, потом на рейтинги: 8B на 8 ГБ, 14B на 16 ГБ, 30B на 24 ГБ, и всегда с запасом под контекст.
- Qwen3 — самый надёжный дефолт из-за линейки размеров и свободной лицензии; на Mac стартуйте с Gemma 4.
- Оболочка решает не меньше модели: Ollama закрывает 90% потребностей, vLLM нужен только под нагрузку.
- Q4 — компромисс, который делает всё возможным; Q8 берите, только если память девать некуда.
- Локальное и облачное не конкуренты, а два слоя одной рабочей схемы.
FAQ
С чего начать новичку? С Qwen3 через Ollama, на Mac — с Gemma 4. Установка занимает минуты, дальше можно спокойно экспериментировать с размерами.
Сколько нужно памяти? 8 ГБ для 7–8B, 16 ГБ для 14B, 24 ГБ для 30B, 48 ГБ и выше для 70B — при 4-битном квантовании и умеренном контексте.
Это бесплатно? Модели и оболочки бесплатны и открыты. Платите один раз за железо и потом за электричество; за токены — ничего.
Ollama или LM Studio? Ollama, если нужен API и терминал; LM Studio, если удобнее сравнивать модели мышкой.
Локальная модель хуже ChatGPT? На рутине — почти нет. На длинных рассуждениях и очень крупных проектах — да, разрыв сохраняется.
Годится ли для программирования? Это одно из лучших применений. Qwen3-Coder и Devstral 24B уверенно работают агентами начиная с 24 ГБ; на 16 ГБ реальны автодополнение и отдельные фрагменты.